手动检查几个产品页面还算容易。但每天追踪价格、库存水平或新发布的职位信息,则是另一回事。你需要一种可重复的方法来逐一查看结果、收集相同的字段信息,并检查是否有遗漏。
列表爬取功能正是为此而设计的。它将网站列表转换为结构化记录,供您进行比较、存储和更新。随着工作量的增加,挑战也从下载页面转变为确保整个收集过程的可靠性。
本指南介绍了列表爬取的功能、适用场景,以及如何构建一个能够逐步扩展的工作流——从一个简单的 Python 示例开始,逐步扩展到任务调度、数据校验以及 IPFLY 代理集成。
什么是列表爬取?
列表爬取是一种自动采集任务,它会遍历网站列表并提取重复的记录。爬虫可能会访问某个产品类别的每一页,收集每个产品的标题和网址,并将结果保存到表格中。这种方法同样适用于招聘网站和商业名录。
此处,该术语指的是收集索引数据。一些SEO工具也使用“列表爬取”来描述对一组给定的URL进行审核,但这属于另一项任务。
页面和记录:列表爬虫的目标
列表页面包含具有共同结构的重复项。每个项都成为一条记录,而其属性则成为字段。
例如,产品详情页可能会提供:
- 产品名称和详情页网址。
- 标价及货币。
- 库存状态说明。
- 评分或评论数量。
列表页面可能并未包含您所需的所有信息。规格、完整描述或交货条款可能仅在详情页面中显示。在添加额外请求之前,请先确定哪些字段对您重要。
一条有用的记录还应包含其来源页面和采集时间。这些字段有助于说明该值来自何处以及何时被观察到的。
列表爬取、网页爬取和网页抓取
这些活动虽然存在重叠,但它们描述的是工作的不同部分。
| 活动 | 主要任务 | 典型结果 |
| 网页爬取 | 发现并访问网址 | 一组网页或URL |
| 网页抓取 | 从页面内容中提取信息 | 选中的字段或文本 |
| 列表爬取 | 遍历列表并收集重复项 | 结构一致的记录 |
列表爬虫可以同时完成这三项任务:发现下一页、下载该页面以及提取其中的记录。将这些职责分开处理,有助于更轻松地定位故障。
为什么在定期数据采集时要使用列表爬取?
价值源于反复的观测。单次数据采集仅能反映某个时间点的状况。而定期采集则有助于揭示发生了哪些变化。
跨产品、任务和目录跟踪更改
以一个价格监测项目为例。一次性收集产品名称和价格可以生成一个“快照”。如果按照固定时间表进行收集,并使用稳定的产品标识符,则可以对不同时间点的观测数据进行比较。
同样的模式也适用于其他任务:
| 来源 | 需收集的字段 | 数据能解答的问题 |
| 产品列表 | 产品编号、价格、库存情况 | 哪些产品的价格发生了变化? |
| 招聘网站 | 职位编号、雇主、工作地点、发布日期 | 最近出现了哪些角色? |
| 商业名录 | 房源编号、类别、网站 | 哪些条目是新增或更新的? |
将房源信息转化为用于报告和决策的数据
与保存的截图或复制的页面文本相比,一致的记录更易于使用。它们可以作为电子表格、报告系统或警报的数据来源。
在收集数据之前,请先定义字段映射。例如,需确定不可用价格是否显示为空值、日期是否采用UTC时间,以及可用性是存储为原始文本还是规范化类别。
当转换可能导致含义丢失时,应保留原始值。同时保留 price_raw 和已解析的数值,可使后续的检查更加便捷。
判断何时值得保留自动收款功能
当您需要反复访问、清晰的字段控制以及可维护的工作流时,使用自定义爬虫是明智之选。
首先应确认是否有官方发布的出口数据、已获许可的数据集或授权的 API 已经提供了所需的信息。构建爬虫会带来持续的工作:页面变更、请求失败、数据存储以及监控。
对于小型的一次性任务,手动收集或导出可能就足够了。对于周期性任务,请将全部维护成本与当前数据的价值进行比较。
选择适合该网站的收款方式
在选择框架之前,请先查看一个具有代表性的页面。您的方法应遵循该网站提供数据的方式。
定位数据和分页信号
请先检查原始的 HTML 响应。如果所需字段已经存在,则直接发送 HTTP 请求可能就足够了。
如果记录仅在交互后出现,请检查浏览器的网络活动。确定该网站是使用现有的数据接口,还是需要浏览器进行渲染。在使用端点之前,请确认访问条件。
然后确定列表后续的内容:
- 下一页的链接。
- 页码或偏移量。
- 每批数据都会返回一个光标。
- 一个用于加载更多记录的按钮。
- 一种请求另一批数据的滚动操作。
请保持筛选条件、排序方式和区域设置的一致性。否则,后续页面显示的结果集可能会有所不同。
根据页面行为选择合适的工具
| 方法 | 合适的起点 | 主要权衡 |
| 请求 + BeautifulSoup | 以HTML格式呈现的记录 | 你实现了分页和任务控制 |
| Scrapy | 跨多个页面的重复 HTTP 数据收集 | 需要进行框架的配置和维护 |
| 剧作家 | 需要浏览器交互或渲染 | 占用更多的计算资源 |
| 托管收款服务 | 减少基础设施维护 | 添加服务成本和供应商限制 |
关于解析和请求处理的背景知识,IPFLY 的 Python 集合教程介绍了其基本构成要素。
从能返回所需数据的最简单方法开始。当页面行为需要时,再添加浏览器自动化功能。
用 Python 构建你的第一个列表爬取程序
下面的示例使用了练习网站“Books to Scrape”。它会跟随“下一页”链接,并将记录写入一个 JSON Lines 文件,该文件中的每一行都包含一个 JSON 对象。
这是一个关于该网站结构的教学示例。其中不包含生产调度或恢复内容。
定义起始 URL 和输出字段
安装依赖项:
python -m pip install requests beautifulsoup4将以下示例保存为 list_crawl.py。该程序收集标题、详情网址、原始价格、来源页面和观察时间。
详细信息 URL 作为该示例的记录键。在生产源中,如有可用,请使用稳定的源 ID。
提取并验证单页
解析器会检查商品详情页是否存在,以及每张详情页是否包含标题链接和价格。遇到意外页面时,系统会触发错误,而非返回成功的空结果。
遵循分页规则并保存结果
import json
import time
from datetime import datetime, timezone
from urllib.parse import urljoin, urlparse

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3  # A small trial, not a full-site run.


def parse_page(html, page_url):
    soup = BeautifulSoup(html, "html.parser")
    cards = soup.select("article.product_pod")

    if not cards:
        raise ValueError("Expected product cards were not found")

    records = []
    for card in cards:
        link = card.select_one("h3 a")
        price = card.select_one(".price_color")

        if link is None or not link.get("href") or price is None:
            raise ValueError("A product is missing required elements")

        records.append({
            "title": link.get("title") or link.get_text(strip=True),
            "url": urljoin(page_url, link["href"]),
            "price_raw": price.get_text(strip=True),
            "source_page": page_url,
            "observed_at": datetime.now(timezone.utc).isoformat(),
        })

    next_link = soup.select_one("li.next a")
    next_url = (
        urljoin(page_url, next_link["href"])
        if next_link is not None and next_link.get("href")
        else None
    )
    return records, next_url


def main():
    page_url = START_URL
    visited = set()
    seen_records = set()
    pages = 0
    saved = 0
    reason = "page_limit"
    allowed_host = urlparse(START_URL).netloc

    with requests.Session() as session, open(
        "books.jsonl", "w", encoding="utf-8"
    ) as output:
        session.headers["User-Agent"] = "ListCrawlLearningExample/1.0"

        while page_url and pages < MAX_PAGES:
            if page_url in visited:
                raise RuntimeError("Repeated pagination URL")
            if urlparse(page_url).netloc != allowed_host:
                raise RuntimeError("Pagination left the allowed host")

            response = session.get(page_url, timeout=(10, 30))
            response.raise_for_status()
            records, next_url = parse_page(
                response.content, response.url
            )

            for record in records:
                if record["url"] not in seen_records:
                    output.write(
                        json.dumps(record, ensure_ascii=False) + "\n"
                    )
                    seen_records.add(record["url"])
                    saved += 1

            output.flush()
            visited.add(page_url)
            pages += 1
            page_url = next_url

            if page_url is None:
                reason = "end_of_list"
                break

            if pages < MAX_PAGES:
                time.sleep(2)

    print({
        "pages_processed": pages,
        "unique_records_saved": saved,
        "stop_reason": reason,
    })


if __name__ == "__main__":
    main()
请使用以下命令运行:
python list_crawl.py在增加数量之前,请检查已保存的记录 MAX_PAGES。请对照源页面核对若干商品名称、链接和价格。
该摘要区分了“有意设置的页面限制”与“列表末尾”。请求或解析错误会引发异常并终止脚本执行;此时不会显示成功完成的摘要。已写入的记录仍然可用,但若再次运行该脚本,文件内容将被覆盖。
对于这次小型演示而言,两秒的延迟是一个保守的选择,并非通用的速率建议。
系统全面的代理IP知识
从代理原理到协议选型,IPFLY助您搭建完整的代理认知体系
设计一个能够随业务发展而扩展的工作流
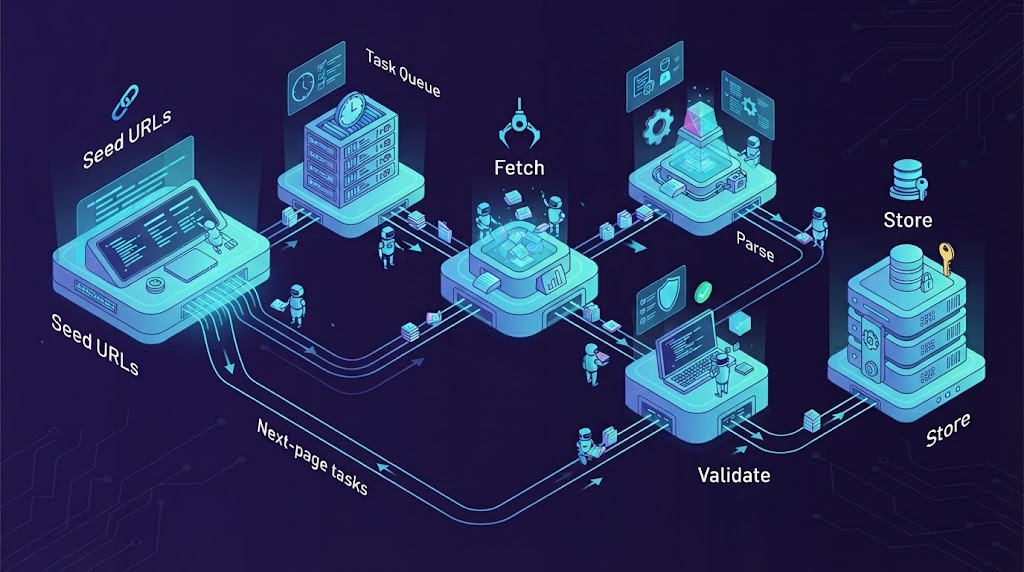
一旦基本解析器能够正常运行,就改进任务在系统中的流转方式。
将队列、获取和解析阶段分离
较大的工作流程若能划分出明确的阶段,将更具优势:
Seed URLs → Task Queue → Fetch → Parse → Validate → Store
                ↑                  │
                └── Next-page tasks┘
队列负责处理任务。获取操作处理网络响应。解析操作将预期的页面转换为记录。验证操作决定这些记录是否符合数据契约。
将列表页任务与详情页任务分开处理。这样就可以独立地更改它们的优先级或重试规则。
控制请求的加载以及恢复失败的任务
对所有 worker 设置每个网站的流量限制。如果在没有统一流量限制的情况下增加 worker 数量,可能会产生超出预期的流量。
对于临时性故障,应采用有限重试。收到 Retry-After 响应。若收到“访问被拒绝”的响应,则需进行排查;反复重试可能会增加系统负载,却无法解决根本原因。
将待处理任务和已完成的工作持久化。只有在任务的输出已安全存储后,才保存该任务的完成状态。稳定的记录键有助于防止在工作者因崩溃后重复执行任务时产生重复记录。
Scrapy 通过其任务持久化功能,提供了基于磁盘的请求调度及重复内容过滤。其任务文档还详细说明了恢复爬取操作的条件和限制。
根据数据时效性调整日程安排
根据数据何时能发挥作用或过时,选择相应的更新周期。
请将您观察到记录的时间与来源中显示的任何发布或更新日期区分开来。它们描述的是不同的事件。
除非系统能够协调,否则应避免计划任务重叠执行。一个运行缓慢的任务不应在后台悄然触发另一个针对相同页面的完整任务。
使用 IPFLY 来满足您的爬虫网络需求
对于小型数据采集任务,可能无需代理即可运行。当工作流需要特定的网络位置、专用的出站地址,或者在独立请求之间进行受控变更时,代理就变得重要了。
截至2026年10月21日,IPFLY官网显示其拥有超过9000万个住宅IP地址,覆盖190多个国家和地区。这些数据由服务商自行申报,并不能确定特定城市中可用的地址数量,也无法保证针对您目标对象的成功率。
为您的工作负载选择一种 IPFLY 代理类型
| 要求 | IPFLY 评估选项 | 缩放前请先检查 |
| 支持可配置地址变更的区域观测 | 轮换住宅代理 | 所需位置、会话控制和流量配额 |
| 一个专用的、稳定的出站地址 | ISP代理 | 地点可用性及地址连续性条件 |
| 面向吞吐量的采集中的固定端点 | 专用数据中心代理 | 目标兼容性与实测工作负载成本 |
IPFLY 的 ISP 代理页面列出了专用静态地址以及对 HTTP(S)/SOCKS5 的支持。其数据中心代理页面也列出了专用 IP 地址以及这些协议。
这些选项可满足不同的网络需求。静态页面并不一定需要数据中心代理,而动态页面也不一定需要住宅代理。
在选择住宅代理方案之前,请先查阅 IPFLY《住宅代理使用指南》中的实用配置概念。请在您的账户中确认当前套餐详情及可用位置。
将 IPFLY 连接到您的 Python 爬虫
复制为您账户生成的代理 URL。将其存储在一个名为 IPFLY_PROXY_URL中,避免将凭据保存在共享源文件中。
在之前的脚本中,添加以下导入语句:
import os然后将其 session.get(...) 调用替换为:
proxy_url = os.environ["IPFLY_PROXY_URL"]

response = session.get(
    page_url,
    proxies={
        "http": proxy_url,
        "https": proxy_url,
    },
    timeout=(10, 30),
)
请使用 IPFLY 提供的端点、端口、协议和凭据。本示例未假设存在通用的网关地址或身份验证格式。
字典键用于标识目标 URL 方案。代理 URL 本身的方案用于标识与代理的连接。Requests 在其官方代理文档中对这些设置进行了说明。请保持 TLS 验证处于启用状态。
使会话行为与目标网站保持一致
有些任务是独立的。有些则依赖于Cookie、光标,或者跨越多个请求的服务器端会话。
对于有状态的序列,请保持所需的会话设置一致。在不同页面之间更改发信地址可能会导致某些网站上的该序列中断。
IPFLY 在其关于轮询和会话控制的概述中介绍了“按请求”和“粘性会话”选项。粘性会话是一种临时地址保持机制,而非永久的静态 IP。
首先定义逻辑任务,然后确定何时适合更改地址。IPFLY 对轮询策略的讨论为区分独立请求与会话型任务提供了更多背景信息。
在增加训练量之前,先评估训练效果
在比较配置时,请使用相同的目标 URL、字段和请求限制。衡量标准:
- 已收集到有效的唯一记录。
- 按类型查看请求错误。
- 响应时间和传输字节数。
- 总催收费用。
一个有用的成本衡量指标是:
每个有效唯一记录的成本 = 总测量运行成本 ÷ 有效唯一记录数
如适用,请包含浏览器或服务费用。即使某配置的标称单价较低,但如果其产生的失败或无法使用的结果更多,实际成本仍可能更高。
在审查带宽承诺时,IPFLY关于评估代理网络限制的指南具有参考价值。实际上,带宽、传输数据量、并发数和请求数是各自独立的衡量指标。此外,服务商的连接带宽并不能消除目标网站的流量限制。
在使用数据之前对其进行验证
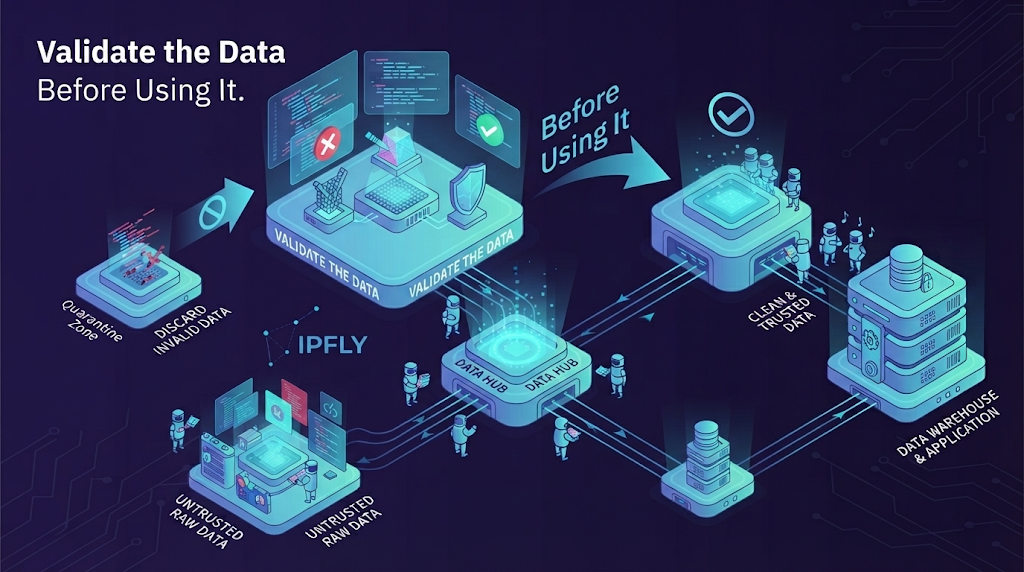
“已完成的工作”是指工作流已完成其计划中的任务。数据验收需要进行单独的检查。
字段规范化与删除重复记录
使用“源数据感知”规则转换字段。保留货币、单位和日期上下文,而不是将其移除。
当需要进行精确运算时,请使用小数值或整数形式的次级单位来表示货币。当格式可能发生变化时,请在解析后的数值旁保留原始文本。
在正确的范围内进行去重。一个产品 ID 可能对应一个产品,但该产品在两个地区的价格则代表两个观测值。一个合适的观测键可能包括来源 ID、地区和运行 ID。
检查覆盖率并在不同运行之间跟踪更改
共同审查记录数量、字段完整性、重复率以及未解决的错误。
为了说明问题,假设某条列表显示了500条结果,但爬虫仅保存了420条唯一记录。这种差异说明有必要调查分页、筛选条件、失败页面以及显示的总数所代表的含义。但这并不能证明恰好遗漏了80条记录。
在已接受的测序运行中追踪新记录和已更改的记录。在数据覆盖率足够高、足以支持剔除决策之前,将缺失的记录视为“本次测序运行中未观察到”。
排查常见列表爬取故障
请根据以下证据选择下一个复选框。
| 症状 | 待查验的证据 | 下一步行动 |
| 仅收录了第一页 | 下一页链接或后台请求 | 确认延续状态已进入下一阶段 |
| 不同的页面返回相同的记录 | 请求的 URL、光标和返回的 ID | 检查重复使用的参数和会话状态 |
| 成功的响应中没有预期字段 | 内容类型和已保存的响应示例 | 确认该响应是否为预期的列表页面 |
| 代理身份验证失败 | 代理状态和生成的凭据 | 检查端点和身份验证设置 |
| 请求受速率限制 | 状态、标头和总请求率 | 减慢或暂停该作业,并遵守重试指令 |
| 记录数量骤降 | 未完成的任务和现场填写率 | 比较页面样本,仅对未解决的工作重新尝试 |
| 结果显示的区域背景有误 | 退出位置、语言、Cookie 和过滤器 | 调整相关设置,并再次进行简短检查 |
请妥善保存诊断样本。在共享日志之前,请先删除凭据和敏感数据。
结论
可靠的列表爬取首先要基于清晰的数据集和经过验证的单页解析器。在扩大爬取规模之前,应先添加分页、恢复和数据校验功能。如果工作流需要区域访问权限或受控的网络出口,请通过小规模、可量化的测试来评估 IPFLY,并根据收集到的记录的质量和成本进行规模调整。